DeepSeek представила DeepSeek-OCR — новую модель для сжатия визуального контекста в LLM


Компания DeepSeek показала DeepSeek-OCR — OCR-модель, созданную специально для больших языковых моделей. Вместо обычного распознавания текста она сжимает страницу в визуальные токены, чтобы LLM могла читать документы быстрее и дешевле.

На vLLM 0.8.5 модель выдаёт около 2500 токенов в секунду на GPU A100-40G. Postium собрал ключевые детали о новинке.

DeepSeek-OCR — что это и как работает

DeepSeek-OCR — новая система распознавания текста от компании DeepSeek, созданная специально для работы с большими языковыми моделями (LLM).

Главная идея — не просто превращать изображение в текст, а сжимать визуальный контекст страницы (документа, PDF) в компактный набор токенов, которые LLM потом «распаковывает» и понимает.

Как это работает:

  1. Страница превращается в визуальные токены. Модель анализирует изображение (скан, PDF) и кодирует его в десятки, а не тысячи токенов.
  2. LLM получает компактное представление. Эти токены уже содержат информацию о тексте, структуре (таблицы, списки) и формате документа.
  3. Распаковка и понимание. Внутри LLM эти токены преобразуются обратно в текст и структуру — без необходимости видеть каждый пиксель.

Результат — LLM понимает документ целиком, но тратит в 10–20 раз меньше контекста, чем при обычном OCR.

На бенчмарке OmniDocBench DeepSeek-OCR опережает GOT-OCR 2.0 и MinerU 2.0, используя при этом в 2–3 раза меньше визуальных токенов.
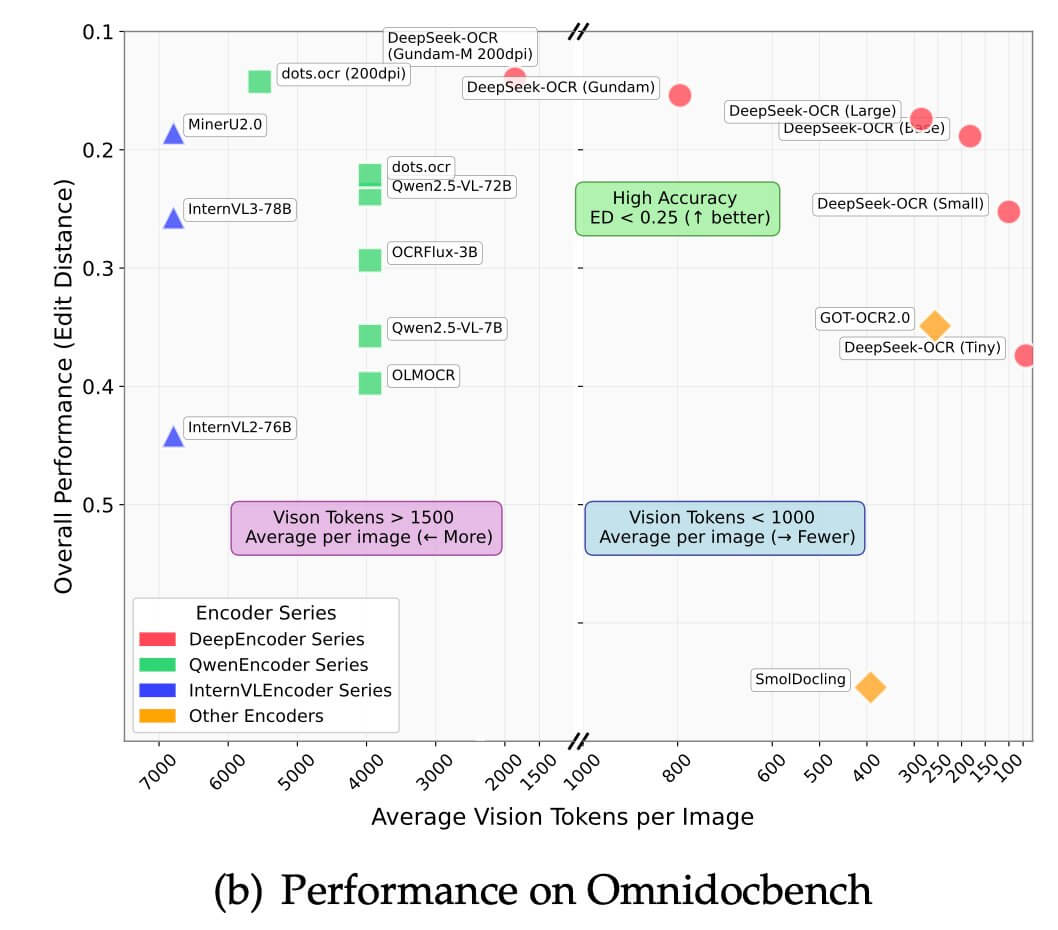
Почему это важно: DeepSeek-OCR делает работу LLM с документами быстрее — до 2500 токенов/с на GPU A100, дешевле — за счёт меньшего числа токенов при инференсе, точнее — сохраняя 97% точности при 10-кратном сжатии, и гибче — поддерживая PDF, сканы и изображения напрямую через vLLM.

Где может применяться:

  • Автоматический разбор контрактов, отчётов, форм;
  • Быстрое извлечение данных из длинных PDF;
  • Подготовка структурированных ответов (JSON, Markdown, таблицы);
  • Встраивание в RAG-пайплайны и чат-ботов с документами.

Как пользоваться? DeepSeek-OCR — инструмент для разработчиков, а не конечных пользователей. Модель можно скачать с Hugging Face или GitHub и встроить в свои пайплайны — например, в веб-сервисы, системы анализа документов или обработку больших данных.

Она принимает на вход изображения, сканы и PDF-страницы, возвращая компактные визуальные токены или распознанный текст. Совместима с vLLM 0.8.5, Transformers, PyTorch 2.6+ и работает на CUDA 11.8+.

Итог: DeepSeek-OCR не делает ИИ «зрячим» в человеческом смысле, но приближает его к тому, как человек воспринимает документ.

Раньше OCR видел только буквы и строки, не понимая, где таблица, где подпись, а где заголовок. Теперь модель передаёт LLM сжатое, но осмысленное представление страницы — так, как человек видит её целиком: и текст, и структуру, и логику оформления.

Также, недавно стало известно, что DeepSeek V4 может выйти в октябре.


Источник

Межтекстовые Отзывы
Посмотреть все комментарии
guest

Tencent выпустила Hy Image 3.5 Preview для генерации и редактирования изображений

Tencent открыла доступ к Hy Image 3.5 Preview — модели, которая создаёт изображения по тексту и референсам, а...

Новое поколение DLSS 5 от NVIDIA: революционный ИИ-рендеринг выйдет 3 сентября

Компания NVIDIA официально анонсировала технологию DLSS 5, запуск которой запланирован на 3 сентября 2026 года. Первой игрой с...

OpenAI выпустила приложение Sora на Android — пока только в 7 странах

OpenAI представила Android-версию приложения Sora — инструмента для генерации коротких видео с помощью искусственного интеллекта. Скачать ИИ-генератор видео...

Alibaba выпустила Qwen-Image-3.0 без весов и бенчмарков, но с промптами на 4500 токенов

Alibaba выпустила Qwen-Image-3.0 - третье поколение генератора изображений с прицелом на практическую пользу: длинные детальные подписи, читаемый мелкий...

Alibaba открыла QwenWork по всему миру — ИИ-агент работает в браузере и на компьютере

Alibaba открыла международную версию QwenWork в формате публичной беты. Это рабочая платформа с ИИ-агентом: пользователь описывает задачу обычным...

Новые фишки и функции iOS 27 для iPhone — 13 главных обновлений

Недавно Apple выпустила iOS 27 — обновление доступно для iPhone 11 и более новых моделей, а также iPhone...

Kimi управляет сайтами из боковой панели Chrome и запоминает действия

Kimi теперь открывает сайты, нажимает кнопки и заполняет формы по просьбе, написанной в чате. Moonshot AI переименовала своё...

Runway показала GWM Worlds 2 – интерактивный мир вместо видеоролика

Runway 3 сентября показала GWM Worlds 2 - мировую модель, которая выдаёт живое интерактивное пространство вместо готового ролика....

GLM 5.2. Мощная модель в открытом доступе

Китайская компания Zhipu AI, которая на международном рынке работает под именем Z.ai, этим летом выпустила новую большую языковую...

Kling добавила нативную генерацию в 4K в версии Video 3.0

Kling запустила режим 4K Mode в линейке Video 3.0. Теперь видео можно генерировать сразу в 4K — без...

«Звук» запустил «Атлас» — интерактивную карту музыкального вкуса

Музыкальный сервис «Звук» запустил «Атлас» — персональную карту, которая показывает любимые жанры и настроения пользователя. На ней можно...

20 промтов для осенней ИИ-фотосессии в нейросетях

Осенняя фотосессия не обязательно требует поездки в парк, холодной погоды и пары часов на съёмку. Если у вас...

Консистентность персонажей и стилей в нейросетях — что это и как сохранить

Представьте: вы потратили битый час на промт и наконец получили идеального персонажа. Делаете следующий шаг — просите его...

Нейросеть DeepSeek: регистрация, вход в личный кабинет и как пользоваться на русском бесплатно

DeepSeek – это одна из самых мощных нейросетей, доступная в России бесплатно и без VPN. Поддерживает русский язык...

Gemini взломала три компании на испытаниях и остановилась сама

Gemini во время майских кибериспытаний вошла в системы трёх реальных компаний. В одном случае модель подобрала пароль, в...

Wan3.0 от Alibaba превращает презентации и отчёты в 30-секундные ролики

Alibaba официально запустила Wan3.0 - видеомодель, которая делает ролик длиной до 30 секунд из текста, картинок, аудио и...

ElevenLabs запустила Flows Agent в ElevenCreative — агент строит workflow по текстовому запросу

ElevenLabs представила Flows Agent в ElevenCreative. Пользователь описывает, что хочет создать, а ИИ-агент подбирает модели, добавляет узлы на...

Нейросеть Veo 3.1: как пользоваться и создавать видео бесплатно

Google обновила свою модель для генерации видео — Veo 3.1, и теперь создание роликов со звуком и озвучкой...

Килиан Мбаппе ушёл от Nike и стал амбассадором бренда On

Швейцарский производитель спортивной одежды и обуви On заключил контракт с нападающим «Реала» и сборной Франции Килианом Мбаппе. Футболист...

Google теперь позволит пользователям удалять видимый водяной знак со своих ИИ-генераций

В пятницу Google объявила, что теперь позволит пользователям удалять видимый водяной знак со своих материалов, созданных ИИ, включая...