.ru
Grok 4.7 — новый флагман SpaceXAI, компании Илона Маска, которая выпускает Grok. Модель рассчитана на программирование и многочасовую профессиональную работу, где задача занимает часы, а не одну реплику в чате. Релиз компания подаёт как ровную замену предыдущей версии, потому что цена и скорость остались прежними.
Больше базовая модель, длиннее обучение на трудных задачах
Grok 4.7 собрана на более крупной базовой модели, чем Grok 4.6. Её дообучали длинным циклом обучения с подкреплением, когда модель тысячи раз пробует решить задачу и получает оценку за итог, а не готовый ответ для копирования. Смесь задач специально перекосили в сторону тех, что занимают много часов.
SpaceXAI отдельно вытягивала две вещи, которые ломают длинные сценарии чаще всего. Первая — проверка собственной работы. Модель, не заметившая ошибку на пятом шаге, дальше строит на ней всё остальное, и к финалу результат приходится выбрасывать целиком. Вторая вещь — работа с длинным контекстом, то есть способность не терять условия задачи к её концу.
Ещё одно изменение касается агентной оболочки компании. Grok 4.7 изначально обучена понимать устройство Grok Bot и за счёт этого ровнее ведёт себя в диалогах и общих интеллектуальных задачах.
Два доллара за вход против десяти у Fable 5.1
Ставки Grok 4.7 повторяют прошлую версию. Миллион входных токенов стоит 2 доллара, миллион выходных — 6 долларов. В официальной таблице рядом стоят конкуренты:
- GPT-5 .6 Sol Max — 4 доллара за вход, 20 за выход;
- Fable 5.1 Max — 10 долларов за вход, 50 за выход.
Разрыв заметнее всего там, где его чувствует кошелёк. Долгая агентная задача генерирует огромный объём выходных токенов, и по этой статье Grok 4.7 дешевле Fable 5.1 больше чем в восемь раз. Есть и ускоренная версия модели с удвоенной скоростью генерации, она тарифицируется вдвое дороже обычной.
Главный график релиза меряет стоимость задачи, а не балл
Первым в анонсе идёт CursorBench 4.0 — тест на длинные задачи по программированию. Grok 4.7 набирает там 46,3% против 40,4% у Grok 4.6. У Fable 5.1 в той же строке 51,8%, то есть по чистому результату новая модель вторая.
SpaceXAI подсвечивает не балл, а положение точки на кривой «средняя стоимость закрытой задачи против результата», и формулировка «на переднем крае по соотношению цена-качество» относится именно к ней. Рамка честная, но читать её нужно правильно. Компания говорит не «мы лучше всех», а «за эти деньги лучше нас никого нет».
Семь тестов и что в них меряют
Официальная таблица Grok 4.7 собрана из бенчмарков, названия которых мало о чём говорят за пределами отрасли. Короткая расшифровка:
- CursorBench 4.0 — длинные задачи по написанию кода в редакторе.
- DeepSWE v1.1 — практическая работа программиста с реальным проектом.
- EEBench — задачи по электротехнике.
- AA Briefcase v1.1 — многочасовая офисная работа, результат в баллах, а не в процентах.
- Terminal-Bench 4.0 — долгая работа в командной строке.
- Harvey Legal Agent Benchmark — юридические задачи.
- HealthBench Professional — клиническое рассуждение.
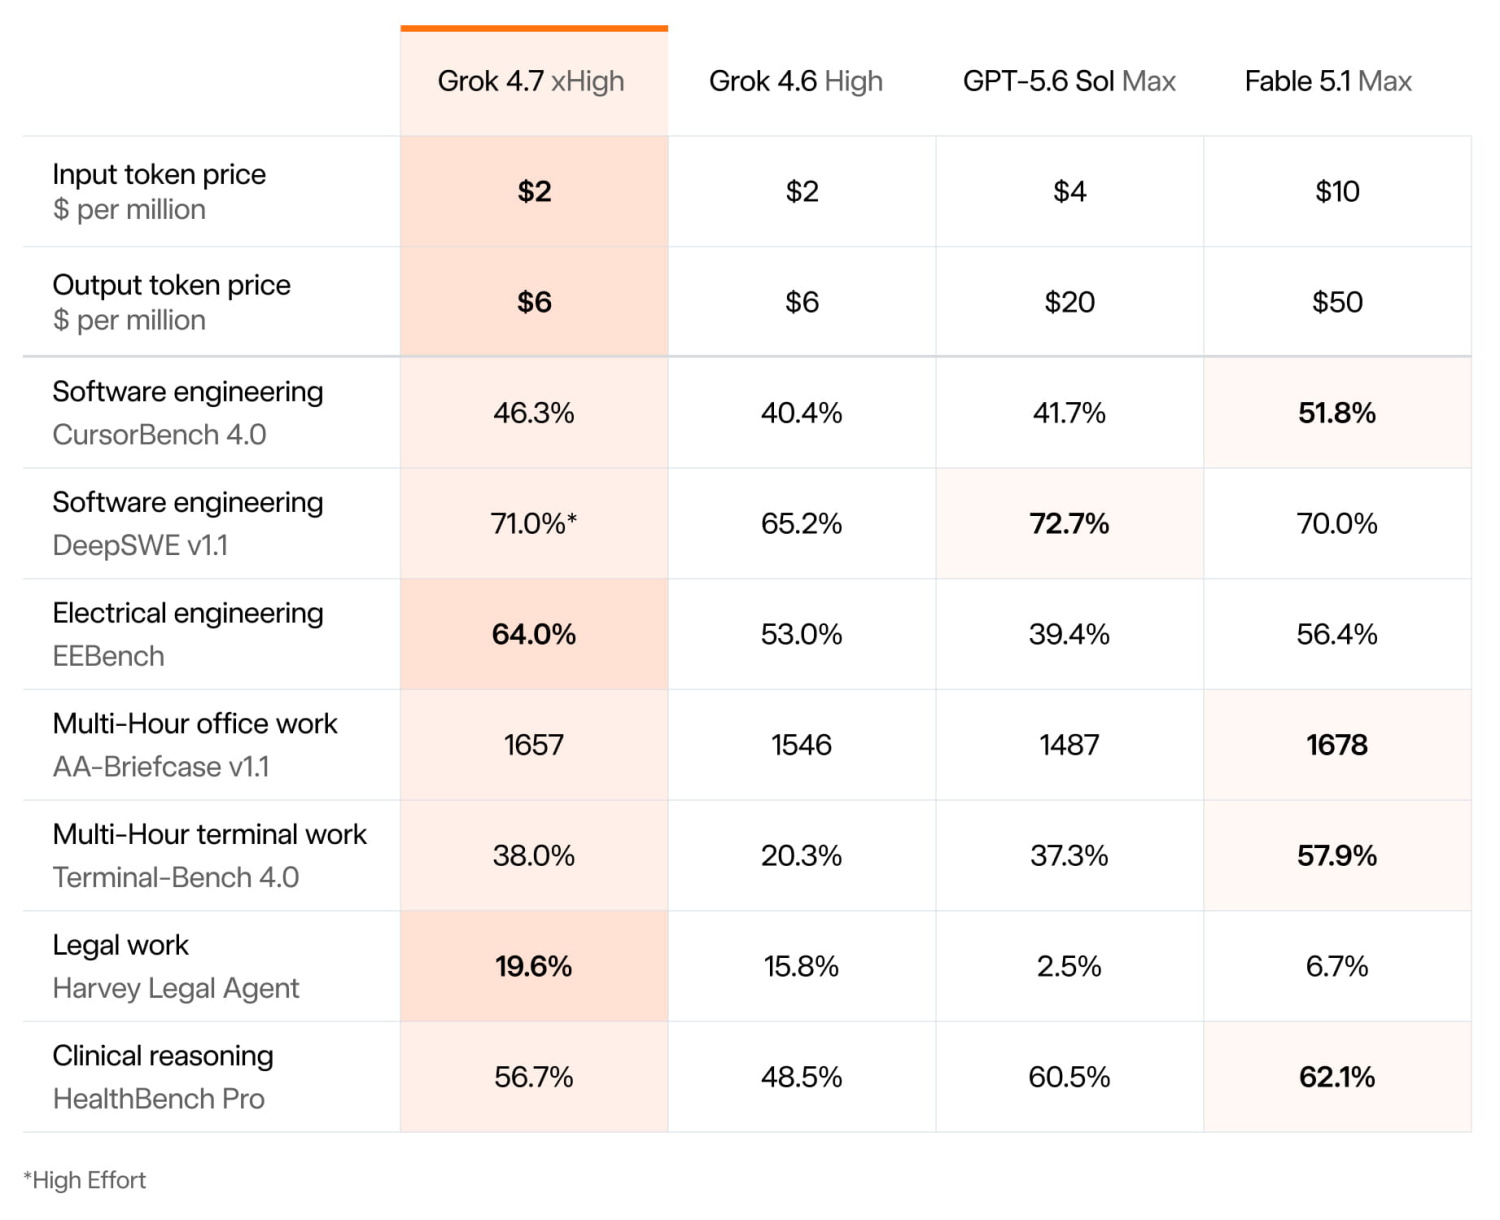
Против Grok 4.6 новая модель выигрывает во всех семи. Самый резкий скачок пришёлся на командную строку, с 20,3% до 38,0%, и на электротехнику, с 53,0% до 64,0%.
Юридические задачи взяты с разрывом втрое, терминал проигран в полтора раза
Прирост у Grok 4.7 неровный, и это самое интересное в таблице. На юридическом тесте Harvey модель набирает 19,6% — против 6,7% у Fable 5.1 и 2,5% у GPT-5.6 Sol. Для бенчмарка, где все участники держатся у нижней границы, трёхкратный отрыв от ближайшего соседа выглядит почти аномалией. На электротехнике картина похожая, 64,0% против 56,4% и 39,4%.
Дальше начинаются проигрыши. В командной строке Grok 4.7 с её 38,0% отстаёт от Fable 5.1 с 57,9% в полтора раза, хотя саму себя прошлую обошла почти вдвое. В клиническом рассуждении модель последняя из четырёх, 56,7% против 62,1% у Fable 5.1 и 60,5% у GPT-5.6 Sol. На DeepSWE её 71,0% помечены звёздочкой как результат на высоком уровне усилий, то есть получены при большем расходе токенов, чем обычный прогон.
Общая картина складывается понятная. Там, где нужна отраслевая эрудиция и длинная цепочка рассуждений, Grok 4.7 берёт уверенно. Там, где нужно долго и аккуратно работать руками в терминале, впереди остаётся более дорогая модель.
В таблице нет ни одной модели Google
SpaceXAI сравнивает себя с Fable 5.1 и GPT-5.6 Sol, а линейка Gemini в материалах релиза не появляется вообще. Выбор соседей по таблице — всегда часть подачи, и отсутствие целого вендора из тройки лидеров стоит держать в голове при чтении процентов.
Ещё одна деталь видна на графике GDPval, где оценивают работу, которую обычно делают профессионалы — юристы, медсёстры, финансовые аналитики. Там Grok 4.7 набирает 1695 баллов и уступает Fable 5.1 с её 1735. Зато соседом снизу поставлена GPT-6 Astra с 1542, хотя в основной таблице от OpenAI участвует GPT-5.6 Sol. Версии конкурентов меняются от графика к графику.
Свой тест на кибератаки и 3,3% пропущенных опасных запросов
Систему безопасности Grok 4.7 компания собрала заново. По внутренним замерам это самая устойчивая к обходу ограничений модель из всех, что SpaceXAI тестировала. На биобезопасности она возглавляет рейтинг LatchBio с результатом 62,4%.
Отдельная цифра относится к кибербезопасности. На собственном тесте компании HackerBench v0.3 модель пропускает 3,3% рискованных запросов двойного назначения, редко блокируя законную работу специалистов по защите. Баланс здесь и есть задача. Слишком строгая модель бесполезна безопаснику, слишком покладистая полезна атакующему. Параллельно SpaceXAI начала выдавать отдельным партнёрам по кибербезопасности доступ к наступательным возможностям Grok 4.7 для исследований в защите, по приглашениям.
Три входа в Grok 4.7
Первый вход бесплатный. Попробовать модель можно в Grok Build, среде разработки компании, она доступна на сайте x.ai/build и в мобильном приложении. Второй вход — редактор кода Cursor , где Grok 4.7 включили в день релиза.
Третий вход для тех, кто строит своё. Ключи выдают в консоли разработчика console.x.ai, модель доступна под именем grok-4.7, контекстное окно 500 тысяч токенов, на вход принимаются текст и изображения. Оттуда же она подключается к сторонним средам разработки, маршрутизаторам моделей и облачным платформам. Для оплаты из России, как и с любым зарубежным API, понадобится иностранная карта, а официальной поддержки региона у SpaceXAI нет.
Длинный контекст по цене, которая не пугает
Для вебмастеров и авторов ценность Grok 4.7 не в баллах, а в арифметике. Пятьсот тысяч токенов контекста за 2 доллара означают, что в один запрос помещается крупный раздел сайта целиком, а прогон обходится в единицы центов. Под такую ставку становятся рентабельными задачи, которые раньше считали слишком дорогими для модели верхнего уровня — массовая переработка описаний, сверка сотен страниц между собой, разбор больших выгрузок.
Одну вещь придётся учесть отдельно. Знания Grok 4.7 обрываются на мае 2026 года, и без включённого поиска модель не знает ничего о событиях после этой даты. Для новостных и обзорных материалов поисковые инструменты в запросе нужно включать явно.
Ставка сделана на стоимость часа работы
Grok 4.7 не пытается быть первой строчкой в каждой таблице и в половине тестов таковой не становится. Заявка построена иначе. Модель предлагает результат флагманского класса по ставке, которая у конкурентов идёт за средний сегмент, и главный аргумент релиза лежит в стоимости закрытой задачи, а не в процентах.
Проверить заявку получится быстро. Grok 4.7 уже стоит в Cursor и API, а значит первые честные цифры по расходу токенов на длинных задачах появятся в ближайшие недели — от тех, кто гоняет модель на своём коде, а не на бенчмарках вендора. Если разрыв в Terminal-Bench подтвердится на живой работе, дешевизна перестанет быть решающим доводом для агентных сценариев.